硬件设备不是我这边维护,所以对硬件故障与更换的情况不清楚。我到现场进行故障处理时被告知 RAID 卡故障,主机的数据文件系统坏了需要修复。
主机文件系统损坏
服务器带外的虚拟终端中一直在打印虚拟块设备 dm-3 的 error,VRM 上显示主机状态为故障,虚拟机不可用。
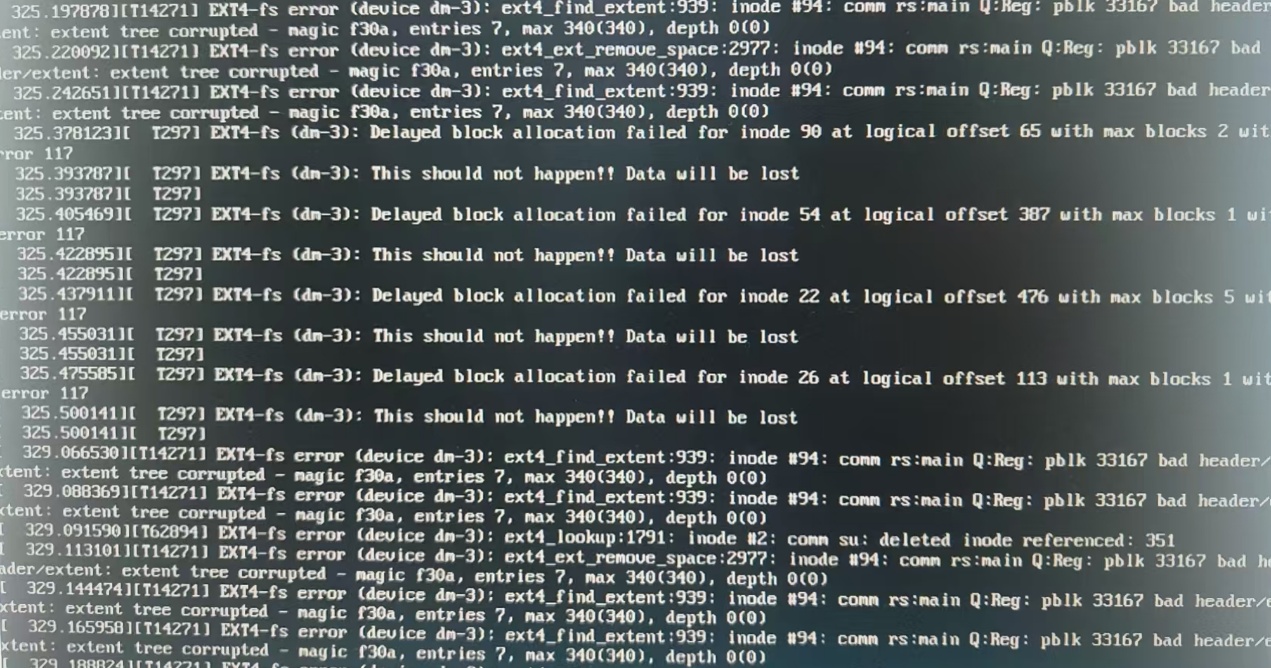
于是重启 CNA,进入内核选择界面按 e 进入 GRUB 界面,输入用户名 root,密码为装机时输入的 GRUB 密码,进入内核修改界面,在 Linux 行后添加
console=tty0 init=/bin/sh rw,Ctrl + X 启动系统进入单用户模式。检查块虚拟块设备和逻辑卷的对应关系
ls -l /dev/mapper/,dm-3 对应 log 分区。
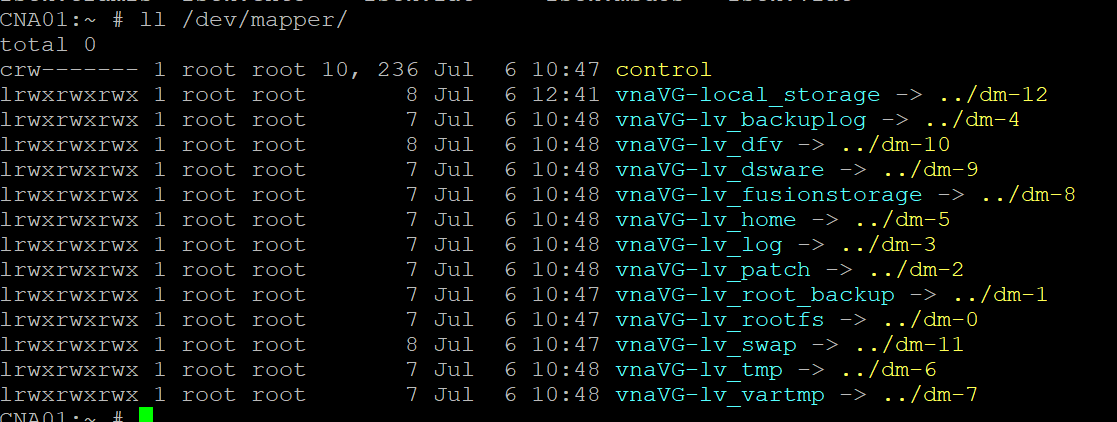
在此模式下没有 fsck 命令,需要挂载其中的 root 分区 vnaVG-lv_rootfs,调用 CNA 系统中的命令:
mount /dev/mapper/vnaVG-lv_rootfs /mnt
/mnt/sbin/fsck -n /dev/mapper/*
/mnt/sbin/fsck.ext4 -y /dev/mapper/*
然后重启系统,进入到系统后发现原用户名密码登录不了系统了,遂重新进入单用户模式,挂载 root 卷到 /mnt 下,chroot 到 /mnt 下,
passwd gandalf、passwd root 修改用户密码,随后重启可以进入系统了,但是又发现网不通了,OVS 的配置全不见了,Mgnt 的端口什么的都没了,
尝试修没修好,没办法只能通过挂载 CNA 镜像安装的时候选择恢复模式,进行修复。
重装 CNA
通过安装介质引导进入 installation(recover)模式,hard drive 选择当前的系统分区,注意不能选错,不要勾选 format all partition 选项。
如果提示:Failed to check whether the system can be restored,需要检查 /etc/new.part 文件。
检查方法:通过上面的进入单用户模式,或者在安装界面按下 Alt + F2 进入命令行模式,输入 root 用户,无需密码,检查 /etc/new.part 文件与正常主机的分区及挂载点是否一致。
重装完成后,重新 cnaInit,随后终于可以通过 VRM 的主机故障恢复将这个 CNA 重新加回 VRM 且保留所有虚拟机和原配置。
VRM 备机故障
VRM 故障,好消息主机似乎修好了,坏消息,VRM 备节点在此主机上,也故障了,一直刷屏 dm-5 有问题,一样的流程进单用户模式修文件系统,再次回来后,VRM 主备间通信的告警消了,但主备数据库异常告警还在。
数据库就会个增删查改,修复故障,我选择饶过自己,遂开了 case。华为官方的建议是重装备节点 VRM,因为使用 fsck 修补好 VRM 可能会导致文件系统里的各种文件有权限问题、目录丢失问题等,
但这边 VRM 做过补丁升级,现场不具备安装 VRM 和升级 VRM 的条件,当初的部署环境都撤了镜像就留了个 CNA 的,没办法还是硬着头皮修,通过命令检查服务状态。
service had query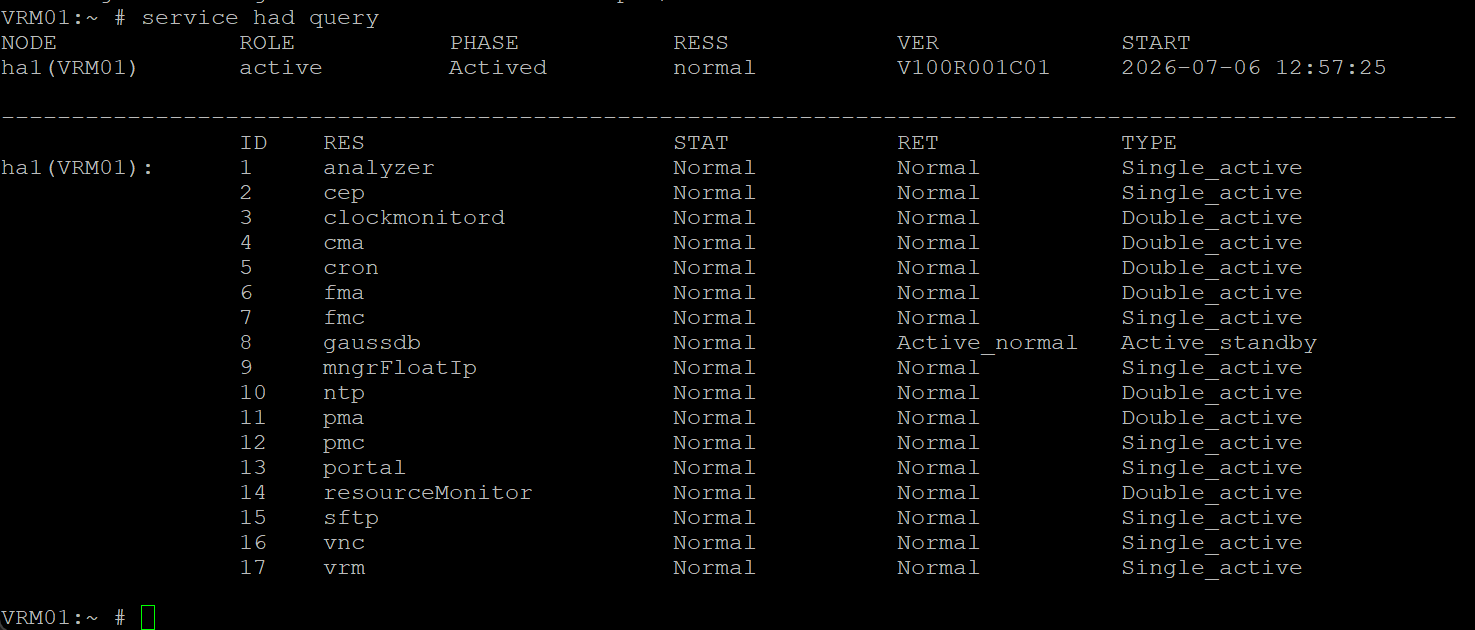
我这里的截图是我的测试环境,非当时现场的截图,现场是主备部署,这里很多服务的状态是异常的。对于备节点,TYPE 为 Single_active 的服务,状态为 STOP 的是正常的,
当主节点挂了的情况下,服务切换到备节点上时才会启动。对于 Double_active 的服务状态应该是运行态,数据库为 standby_normal。
记得现场是 fma、gaussdb 两个服务不正常。数据库不好搞,先去看了 fma,service fmad status,看到服务异常错误信息里有个
/opt/galax/vrm/om/fma/fmad文件不存在的错误,华为的支持人员直接让我去看了/var/log/galaxenginelog/fma 这个文件夹,看了下,log文件权限变成了 root root,遂改成和 VRM 主节点一致,随后该服务就正常了,无需人工重启该服务,VRM 上 had 就是监控和干这个故障恢复的事情的(好像是这样)。
至于为何直接去看log文件的权限,我好像并没有在status状态中看到有这个log文件的报错,应该是经验,当然也可能是我看漏了。
之后就是去修数据库,准备重新 rebuild 数据库然后从主节点同步数据,敲了华为那边提供的命令。命令记不清楚了应该是这个:
su - postgres -s /bin/bash -c "gs_ctl rebuild"
准备重建实例,但报错了,做了很多检查最后发现 vg_vrm-lv_gaussdb 这个逻辑卷也坏了,fsck -n /dev/mapper/* 检查的时候发现这个卷有错误,但我记得 VRM 也是跑过 fsck 的,
没办法再去修一次好了,重新进入到单用户模式,发现 fsck 检查逻辑卷没问题了,当时想的是难道单用户模式下看到的 /dev/mapper 的逻辑卷不是系统正真的逻辑卷,但还是
fsck.ext4 -y /dev/mapper/* 去修了一遍,一样的没有找到有问题的卷组。没办法先开机看看能不能 umount 掉那个 db 的卷组去修,开机后重新再
fsck -n /dev/mapper/* 检查,db 那个卷组的文件系统问题消失了,service had query 检查所有服务都正常了,备节点的 RESS 状态也恢复到了 normal,神特喵的自己好了。
也是很难绷,然后主备倒换验证没问题,VRM 也没有了告警算是把这个问题解决了。
主机主板更换
故障进入高潮阶段,然后客户那边要修主机了,当时我就是一个 WTF,主机硬件有问题还没修吗?不是 RAID 卡坏了吗?那我这修的系统是怎么进来的,黑人问号.jpg。 然后才知道,硬件维保商检查告知主板坏了要换主板,主板还没修,CNA 先出现了故障,让我们这边先来修系统,还真特喵的给系统修好了。那就等好了,等他们换完主板,此时我还不知道,CNA 换主板,官方的建议是,将 CNA 主机移除出 VRM 换完再重新加回来, 产品文档里也有「更换主板」这部分的章节,这是后来开 case 问的时候告诉我的,我是真不知道。但知道了应该也不会这么做,这个环境就两个 CNA,备节点的 VRM 还在这台主机上呢,移除主机要删除网络配置,数据存储配置,相当于回到刚 cnaInit 的状态,无法接受。反正换完主板发现了三个问题,开修。
主机 NTP 服务异常
VRM 上出现主机 NTP 告警,断开连接/连接失败,NTP 服务器肯定是好的,网络也正常,查了华为的案例库有一样的情况,重启 NTP 服务解决。
虚拟机无法迁移
虚拟机迁移时需要选择目标主机,报目标主机的 CPU 架构和当前虚拟机的架构不一致需要开启 IMC,两台主机同一型号,CPU 同一型号,各种检查后发现,更换主板使得主板的 BIOS 比原来更新了,导致没法从更新的 BIOS 架构往低版本上迁移,开启 IMC 重启虚拟机后就可以迁移了。
主机网络冗余丢失
更换主板时把板载的电口网卡也一并更换了,导致新的网卡新的 MAC 导致和原来的配置对应不起来了,VRM 的数据库没有更新能够配置的还是旧的网卡,无法配置新替换上去的板载卡。重新走「主机网卡更换」流程,参考「产品文档 - 故障管理 - 故障处理 - 部件更换 - 更换物理网卡」,
没成功「更新网卡」那个步骤始终报错「主机返回失败」,也可能是我操作的问题,最后直接主机置维护,修改 /etc/udev/rules.d/50-persistent-net.rules 文件,
automatically generated by the install-scripts 部分的网络接口保留原先配置,新识别到的网络接口的 NAME 部分继续延续已有的编号,比如原先已经用到了 eth5,那新识别到的网口就从 eth6 开始用。
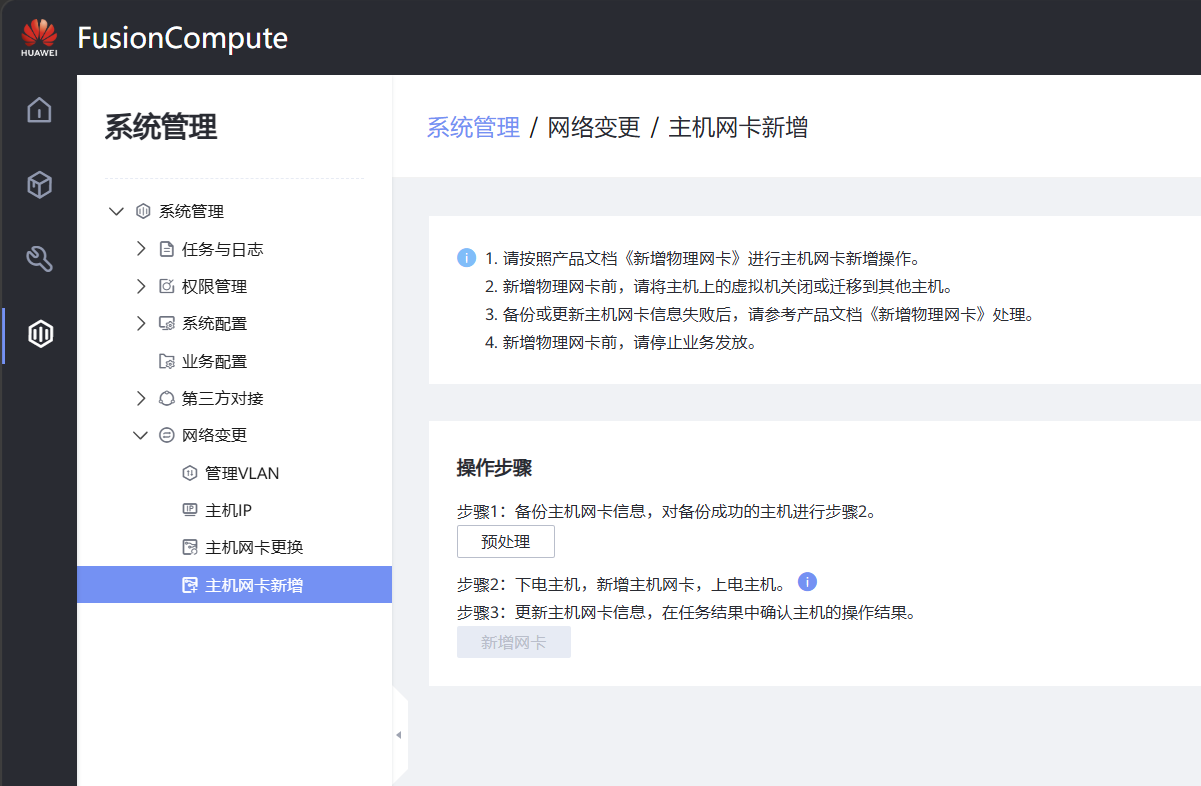
然后也不用再重启主机,去「系统管理 - 网络变更 - 主机网卡新增」那里点「预处理」成功了,就直接点「新增网卡」,之后 VRM 上就同步新增了这台主机上的新网口。
至此,没有发现其他问题了,若是再有,只能遇山开山,遇水架桥了。最后,还是 VMware vSphere 好用啊,岂可修。